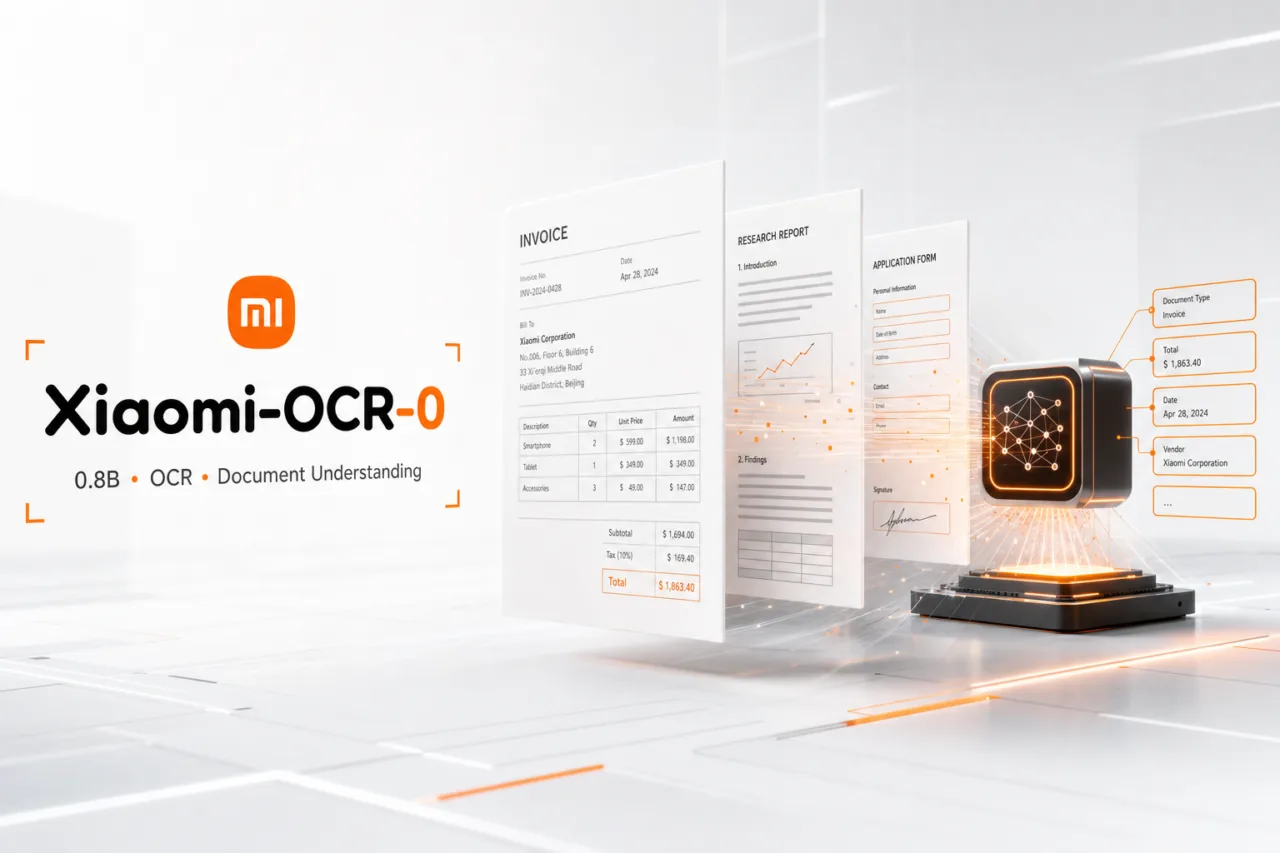
Transformer une photo de document en texte exploitable pose souvent des difficultés : les colonnes se mélangent, les tableaux perdent leur structure et les formules mathématiques deviennent illisibles. Xiaomi Research répond à ce problème avec Xiaomi-OCR-0, un modèle spécialisé de 0,8 milliard de paramètres conçu pour associer la lecture de texte,la compréhension de page et l’extraction structurée.
Le projet propose trois usages précis. Le premier reconstruit un document en Markdown, convertit les tableaux en HTML et restitue les formules en LaTeX. Le deuxième extrait des champs précis sous format JSON pour alimenter des logiciels de gestion. Le troisième permet de poser directement des questions sur le contenu visible d’une page.
Sous licence Apache 2.0, les poids du modèle et le code d’exécution sont mis à disposition sur un dépôt public. Il ne s’agit pas d’une mise à jour logicielle intégrée automatiquement à HyperOS sur les smartphones du fabricant, mais d’un outil open-source destiné aux développeurs et aux entreprises souhaitant installer une solution locale.
Les tests présentés par les chercheurs ciblent des pages scannées, photographiées ou déformées. Les utilisateurs souhaitant automatiser la reprise de données sur des factures ou des rapports techniques doivent toutefois vérifier les résultats obtenus, car une lecture automatisée nécessite toujours une validation humaine pour écarter toute erreur de transcription.