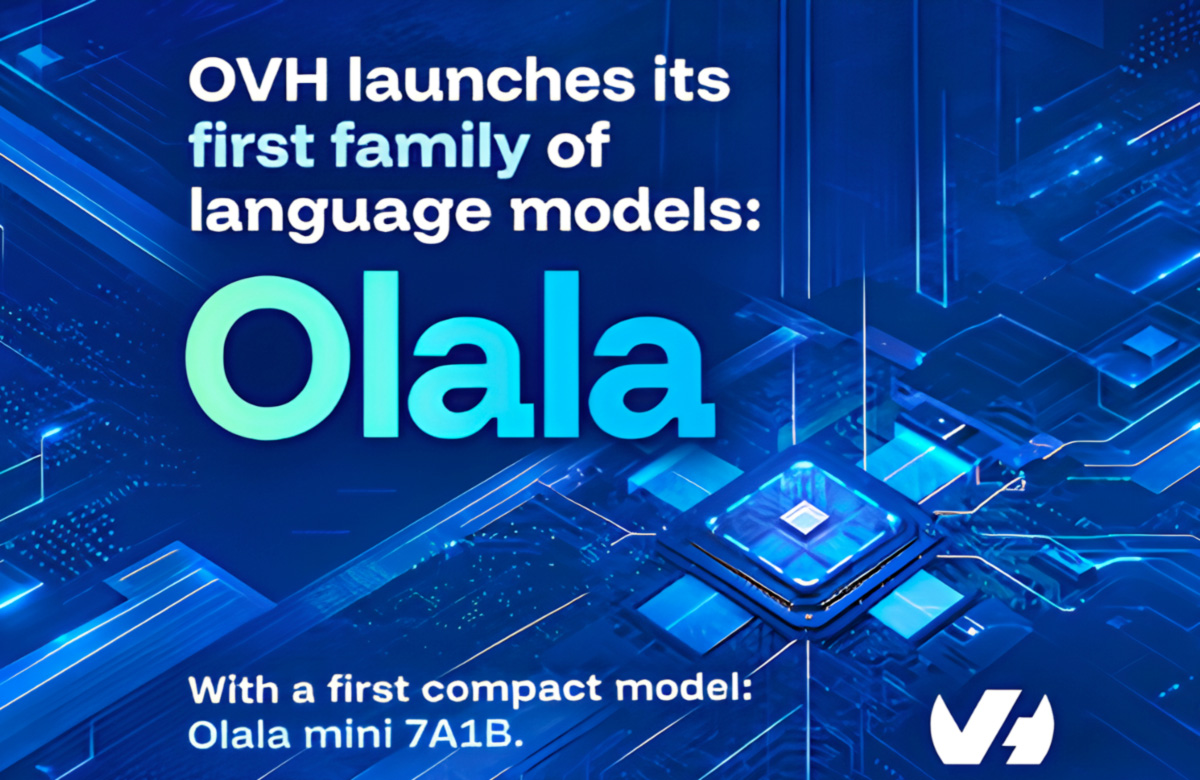
Faire tourner un modèle de langage capable de raisonner et d’appeler des outils sur une machine portable sans carte graphique dédiée pose souvent un dilemme entre vitesse d’exécution et encombrement mémoire. Avec Olala-v1.0-mini-7A1B, son laboratoire OVHai LLM propose une approche taillée pour l’exécution locale, y compris sur un MacBook Air doté de 16 Go de mémoire unifiée.
Nous détaillons ici son architecture hybride, les mesures de débit annoncées selon la quantification et les contraintes techniques à connaître avant de l’installer.
Une architecture hybride à 6,8 milliards de paramètres
Le nom du modèle résume déjà son fonctionnement : Olala-v1.0-mini-7A1B regroupe 6,8 milliards de paramètres au total (couramment arrondis à 7B), mais n’active qu’environ 1 milliard de paramètres par token généré. Cette répartition s’appuie sur un mélange d’experts (Mixture-of-Experts) comptant 256 experts par couche, combiné à une architecture hybride mêlant 29 couches Mamba-3 et 7 couches d’attention Differential-TPA. Seules 7 couches sur 36 conservent un cache KV, ce qui allège la mémoire sollicitée lors des requêtes.
Entraîné sur 12,8 trillions de tokens à partir de jeux de données publics et de données synthétiques, le modèle a mobilisé trois supercalculateurs européens (Jupiter, Jean Zay et MeluXina) pour l’équivalent de 7 millions d’euros d’heures de calcul. OVHcloud publie les poids sous licence Apache 2.0, aux côtés d’un rapport technique et d’une documentation de conformité à l’AI Act.
Côté usages, Olala-v1.0-mini-7A1B gère une fenêtre de contexte de 32 000 tokens, propose quatre niveaux d’effort de raisonnement et intègre l’appel d’outils natif pour des enchaînements d’actions ou des recherches multi-tours. Le moteur de recherche Qwant s’appuie déjà sur lui pour sa fonctionnalité de réponse rapide, avec un gain de vitesse annoncé de 20 % et des coûts de fonctionnement divisés par trois face au modèle précédent.
Débits et quantification GGUF sur MacBook Air 16 Go
Les chiffres communiqués par OVHcloud sur un MacBook Air équipé d’une puce M5 et de 16 Go de mémoire unifiée montrent un comportement surprenant entre les formats GGUF. Sur un test de 512 tokens en entrée et 128 tokens générés, la version Q6_K de 6,3 Go atteint 72 tokens par seconde et 932 tokens par seconde en traitement de prompt (PP). Elle devance ainsi la variante Q8_0 de 6,9 Go (60 tokens par seconde), mais aussi la version compressée Q5_K_M de 6,0 Go qui plafonne à 44 tokens par seconde.
Selon les évaluations de code et de mathématiques rapportées par l’entreprise, ces trois niveaux de quantification restent dans la marge d’ bruit des benchmarks par rapport au modèle d’origine en BF16. La quantification 6 bits offre donc le meilleur compromis mesuré entre débit et maintien des réponses sur ce matériel.
Limites d’outillage pour l’exécution locale
Installer Olala-v1.0-mini-7A1B en local demande toutefois de vérifier ses outils. Les fichiers GGUF (environ 6,3 Go en Q6, pour un fichier complet annoncé à 13,6 Go) fonctionnent sur Mac 16 Go, sur GPU Nvidia ou sur processeur, mais exigent le fork personnalisé de llama.cpp maintenu par OVHcloud. Les versions standards de llama.cpp, Ollama et LM Studio ne prennent pas encore cette architecture en charge. Une implémentation MLX existe également pour les puces Apple Silicon, et les poids comme le code d’exécution sont téléchargeables avec une API compatible OpenAI.
À plus long terme, OVHcloud prévoit une version 1.1 portant le contexte à 128 000 tokens et renforçant le raisonnement mathématique, puis une version 2.0 dépassant les 100 milliards de paramètres orientée vers l’agentique d’entreprise, le DevOps cloud et la cybersécurité. Si vous testez le modèle en local sur votre propre configuration, partagez en commentaire vos mesures de débit et vos retours d’usage.