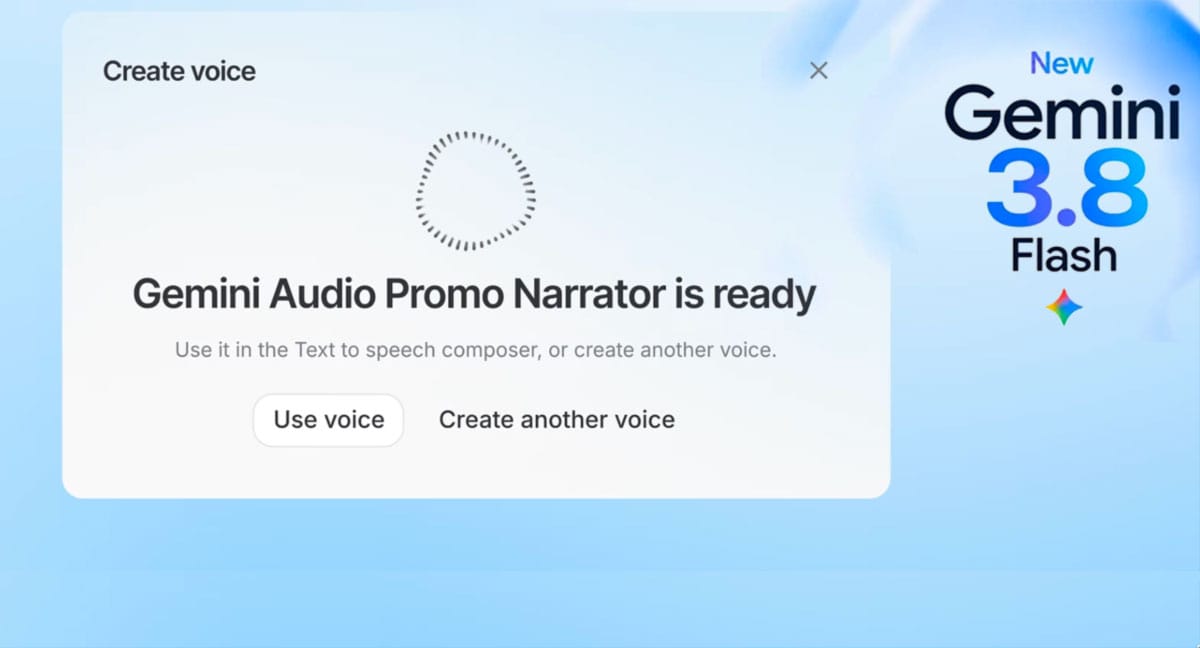
Google met à jour son modèle de synthèse vocale avec Gemini 3.8, une déclinaison text-to-speech conçue pour effacer les intonations métalliques encore fréquentes dans les voix générées par ordinateur. Le système s’attache à reproduire les micro-pauses, les respirations discrètes et les variations d’intensité qui caractérisent une conversation humaine spontanée. L’objectif consiste à rendre les interactions orales avec les assistants moins rigides, que ce soit pour la lecture de longs textes, le guidage vocal ou le dialogue direct sur smartphone.
Sous le capot, l’architecture analyse le contexte d’une phrase complète avant d’en calculer le rendu sonore, évitant ainsi les erreurs d’accentuation sur les mots polysémiques ou les fins de propositions interrogatives. Le moteur adapte son débit selon la densité des informations fournies et gère désormais les hésitations naturelles sans casser le rythme global. Cette gestion fine de la prosodie réduit la fatigue auditive lors des sessions d’écoute prolongée, un défaut récurrent des anciennes versions de Google Text-to-Speech.
Cette mise à niveau cible en premier lieu les téléphones Pixel et l’application Gemini, avant une mise à disposition progressive via l’API Google Cloud pour les développeurs tiers. Les entreprises pourront intégrer ces voix dans leurs serveurs vocaux ou leurs outils d’accessibilité sans recourir à des modèles d’acteurs préenregistrés. Le déploiement débute avec une poignée de langues dont l’anglais et le français, tandis que les réglages de tonalité et de vitesse restent accessibles directement depuis les paramètres système d’Android.